AI出海落地香港避坑指南:DeepSeek私有化部署要多大配置才够?
做联机服或私服的团队,最近几乎都会遇到同一个需求:玩家要AI NPC、要智能问答客服、要自动生成公告和活动文案,但把DeepSeek或Qwen这类模型直接挂到公网API上,延迟、成本和数据外流三个问题同时爆发。于是「落地香港、把模型跑在自己机器上」成了常见解法。但这条路坑不少,下面按真实踩坑顺序拆开讲。
坑一:显存算不清,买完机器才发现跑不动
最常见的误判是拿「模型参数量」当显存需求。实际部署时,显存占用大致等于:权重 + KV Cache + 框架开销。以常见的量化部署为例:7B模型4bit量化权重约4~6GB,14B约9~12GB,32B约20~24GB,70B则要40GB以上。再叠加并发会话的KV Cache,通常要预留30%~50%余量。
- 判断标准:单卡24GB显存可稳定跑14B量化模型,支持个位数并发;32B建议双卡或48GB以上;70B基本要A100/H100级别或多卡并行。
- 避坑点:不要只看「能不能加载」,要看「并发5人时首token延迟是否可接受」。很多私服团队买了32G内存的CPU机器就想跑推理,结果每秒只出几个字,玩家直接流失。
如果只是做AI客服、RAG知识库、公告生成这类轻量任务,用Ollama或vLLM跑7B~14B量化模型,配一张24GB显存的卡就够用,不必上大模型。
坑二:带宽和线路估错,内地玩家访问卡成PPT
香港服务器的核心价值在于「内地与东南亚双向低延迟」,但前提是线路选对。普通国际带宽走内地会绕路,晚高峰丢包严重;CN2线路直连大陆,延迟通常能压到30~60ms,这对联机服和AI对话体验是决定性的。
- 判断标准:要求服务商提供真实测试IP,自己用内地三网分别ping和tracert,看是否走CN2 GIA或优化BGP,晚高峰再测一次。
- 避坑点:「大带宽不限流量」不等于「低延迟」,20M带宽跑AI推理的API请求够用,但如果要同时做直播中转或短剧译制分发,50M起步更稳。
另外,AI推理本身对带宽需求不高,真正的带宽消耗在模型文件下载、日志同步和素材分发上,按实际业务峰值估算即可,不必盲目堆带宽。
坑三:把「免备案」当成「不用管合规」
香港服务器免实名免备案、即买即用,这是效率优势,不是合规豁免。AI出海涉及跨境数据流动,几个红线要清楚:
- 玩家个人数据:如果收集内地用户手机号、支付信息,需评估是否触发数据出境相关要求,通常建议做脱敏或本地化存储。
- 生成内容合规:AI生成的对白、公告、广告素材要有审核机制,避免违规内容直接推送给玩家。
- 模型来源:使用开源模型(DeepSeek、Llama、Qwen等)要遵守其许可证条款,商用前确认授权范围。
判断标准很简单:数据是否涉及内地自然人、是否用于跨境传输、是否有审核日志。三者占其一,就要把合规流程写进部署方案,而不是等出事再补。
坑四:拿云GPU和物理机比价,算错了总账
云GPU按小时计费,短期测试便宜,但长期跑推理成本会快速反超物理机。以7×24运行的AI客服为例,云GPU月成本通常远高于同等算力的物理服务器租用。物理机的优势是算力独占、数据不出机房、带宽稳定。
选型时对比这几项:显存与卡型、CPU核数、内存、系统盘类型、带宽与线路、是否含防御、是否支持免费测试、退款政策。尤其是「真机免费测试」和「不满意退款」这两条,能直接降低试错成本。
选购推荐
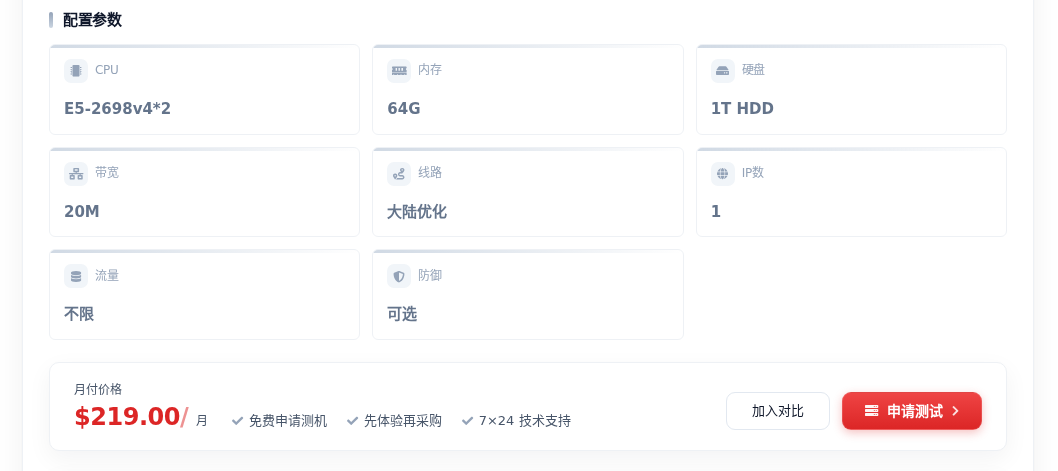
结合联机服与AI出海团队的真实需求,如果主要跑7B~14B量化模型做AI客服、公告生成,并兼顾内地玩家低延迟访问,可以优先考虑香港裸机云 XIII(E5-2698v4*2 / 64G / 1T HDD / 20M带宽,219元/月),内存充足、CN2线路,适合作为推理与业务同机部署的起步机型。
如果还要做素材分发、直播中转或需要更大带宽承载,香港大带宽服务器 XIX(E5-2630L*2 / 32G / 1T HDD / 50M带宽,448.5元/月)的50M带宽更从容,自营机房免备案、即买即用,支持真机测试,适合需要同时兼顾AI服务与内容分发的团队。
决策建议:先用免费测试机验证模型并发延迟和内地线路质量,再按「显存够用、线路优先、带宽按峰值」三条原则下单;合规流程与审核日志从第一天就写进部署文档,别等玩家规模起来再补。