AI出海新热点:内地训练+香港推理,怎样部署才不花冤枉钱?
为什么突然流行“内地训练、香港推理”?
DeepSeek、Llama、Qwen 等开源模型把私有化门槛拉低后,一批 AI 出海小团队开始把训练放在内地——GPU 资源相对好找、电费与机位成本低;把推理节点放在香港——面向东南亚、欧美用户延迟低,且香港机房免备案、免实名,业务上线快。这种分工在近半年从“可选项”变成“默认项”,直接改变了香港服务器的选型逻辑:不再只看 CPU 和硬盘,而是先算显存够不够、带宽撑不撑得住、合规会不会踩线。
对个人站长和自媒体博主来说,典型场景是:在内地用一台带 GPU 的机器或云 GPU 跑微调,把训练好的模型导出成 GGUF 或 ONNX,放到香港服务器上用 Ollama、vLLM 或 TGI 做推理,对外提供 AI 客服、RAG 知识库、AI 绘画接口或短剧译制字幕生成。下面把账拆开算。
成本账:训练、推理、带宽、合规各花多少?
1. 训练侧(内地)
7B 级模型全量微调通常需要 24G 显存以上的卡,租云 GPU 按小时计费,行情大致在每小时几元到十几元;如果只是 LoRA 微调,单张 24G 卡跑一晚就能出结果,成本可控在百元级。个人博主更常见的做法是直接下载社区微调好的模型,训练成本趋近于零。
2. 推理侧(香港)
推理不一定非要 GPU。7B 模型量化到 4bit 后约 4~5G 显存,用一张 T4 或 4090 就能跑;但很多轻量场景(分类、摘要、固定话术客服)用 CPU 推理也够,速度慢一些但成本低一个量级。香港物理服务器月租普遍在几百到两千元区间,云服务器则从十几元/月起,视配置而定。
3. 带宽与延迟
香港到内地走 CN2 线路延迟通常在 30~50ms,到东南亚主要城市在 20~40ms,到美西约 150ms。AI 推理接口单次请求数据量小,10M 带宽即可支撑日均数千次调用;但如果做 AI 绘画、数字人视频生成,单次返回几百 KB 到几 MB,就要按并发估算,通常建议 20M 起步或选大带宽机型。
4. 合规与隐性成本
香港机房免备案免实名,省去内地 ICP 周期,但要注意:面向内地用户提供生成式 AI 服务,仍需关注内容安全与数据出境要求;面向海外则主要看目标市场的隐私法规。这部分没有固定价格,但选错机房可能导致业务下架,属于必须提前确认的“隐性成本”。
怎样选型:个人站长/自媒体博主的配置清单
选购香港推理节点时,按下面清单逐项对比,基本不会踩坑:
- 线路:优先 CN2 或 BGP 直连大陆,问清是否双向 CN2,避免晚高峰绕路。
- 带宽与流量:确认是独享还是共享,不限流量还是 1TB 封顶;AI 接口类业务重点看带宽,视频类重点看流量。
- CPU/内存:CPU 推理至少 8 核 16G 起步;GPU 推理则看显存,7B 量化模型 8G 显存可跑,13B 建议 16G 以上。
- 硬盘:模型文件动辄几 GB 到几十 GB,SSD 是刚需,容量按模型数量预留。
- 是否免备案、是否支持真机测试:能先测试再付款的商家,试错成本最低。
- 退款与售后:确认不满意能否退款、技术支持是否 24 小时在线。
操作步骤上,建议先在内地导出量化模型,再在香港机器上装 Ollama 或 vLLM,用 curl 压测首 token 延迟和并发吞吐,最后接入业务前端。压测时重点记录 P95 延迟,而不是只看平均值。
选购推荐:两款适合起步的香港机型
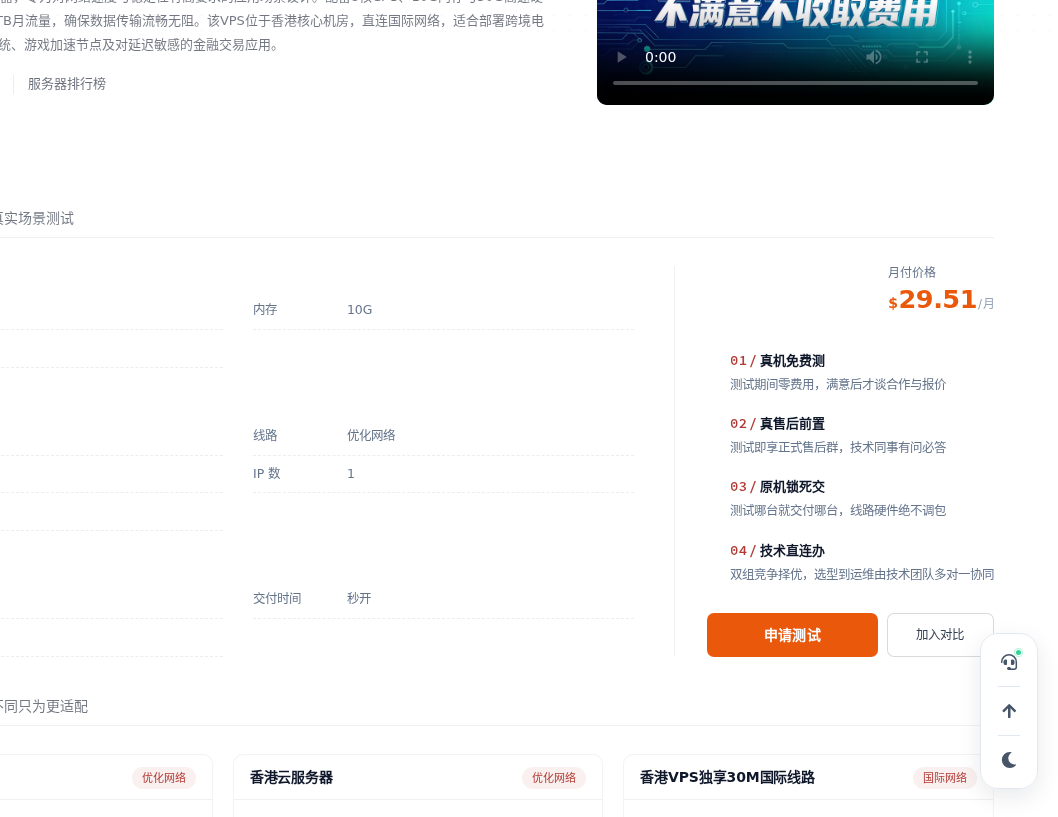
如果只是跑轻量 AI 客服或 RAG 检索接口,起步阶段用香港大带宽(20M)高速云服务器(8H/10G/50G/20M,29.51 元/月)就够,20M 带宽在云服务器里算宽裕,适合先验证业务模型,成本压力极小。
如果推理并发上来、需要稳定跑 7B 量化模型或做 AI 绘画接口,建议上物理机,香港自营国际物理服务器⑨(金牌 6138/32G/1T_SSD/100M,1050 元/月)更合适:100M 带宽应对图片类返回体更从容,自营机房免备案即买即用,且支持真机测试,不满意可退款,对个人博主来说试错成本可控。
决策建议
“内地训练、香港推理”不是万能公式,但对预算有限、面向海外用户的 AI 出海小团队,是目前性价比最高的分工方式。先算清显存和带宽两个硬指标,再按清单对比线路与售后,起步用云服务器验证,跑通后再迁物理机,能少花不少冤枉钱。