Llama私有化部署选型生变:香港服务器如何兼顾跨境金融数据不出境与内地低延迟?
热点变了:从“能不能跑”到“数据放哪、内地访问快不快”
年初还在讨论 Ollama 一行命令跑 Llama,现在外贸企业负责人问得最多的是:香港机房放一台跑 70B 模型的机器,内地同事用起来卡不卡?客户金融数据放香港算不算出境?选型逻辑从“显存够不够”变成了“合规边界 + 物理延迟 + 单次推理成本”的三方权衡。
对做跨境金融、外贸 ERP、独立站客服的中小企业,常见需求是:模型私有化部署在香港,内地团队通过专线或 CN2 访问,数据不落境内第三方云,同时东南亚客户访问也要稳。以下横评三套主流方案。
三套方案横评:云GPU、内地服务器、香港物理机
方案A:境外云GPU按需实例
- 上手最快,按小时计费,适合验证阶段。
- 但长期跑 7B/13B 推理,月成本通常高于物理机,且数据存放在云厂商多租户环境,跨境金融场景做合规说明时较被动。
- 内地访问延迟普遍在 60~120ms,取决于线路,晚高峰抖动明显。
方案B:内地服务器 + 模型本地化
- 内地访问延迟最低,合规适配境内业务。
- 但外贸企业常需调用境外 API、服务海外客户,且部分金融数据来自境外主体,放内地反而产生“数据入境”问题。备案与内容审核流程也会拖慢上线节奏。
方案C:香港物理服务器自建
- 数据落在香港自营机房,物理隔离,不经过内地云平台,便于向客户说明“数据不出境(指不进入内地)”。
- CN2 优质线路直连大陆,内地访问延迟通常可控制在 30~60ms 量级,优于多数境外云区域。
- 免备案、即买即用,适合快速上线。带宽和防御可按需选配,应对 AI 投流、独立站并发。
结论:验证期用云 GPU,正式生产且涉及跨境金融数据,香港物理机是平衡合规与延迟的务实选择。
配置怎么估:显存、内存、带宽速算
显存估算常用经验值:FP16 下每 10 亿参数约需 2GB 显存,70B 模型约 140GB,需多卡或量化。INT8 量化可减半,INT4 再减半,但精度有损,金融问答场景建议 13B 以内用 INT8,70B 用多卡 FP16。
CPU 推理(无 GPU)跑 7B 模型,单次响应常在数秒级,适合低频内部知识库;若要支撑客服并发,建议 GPU 或至少 32G 以上内存 + 高频 CPU。带宽方面,纯文本推理每路并发约需 0.5~2Mbps,10M 带宽可支撑十余路低并发;若涉及 AI 绘画、数字人、短剧译制上传素材,则需 100M 或 G 口大带宽。
选购对比清单:线路(是否 CN2、回程是否直连)、带宽与流量(不限流量还是 500T 封顶)、防御(跨境业务常被扫描,310G 高防更稳)、硬盘(NVMe 对模型加载速度影响明显)、是否免实名免备案、退款与测试政策。
落地步骤与避坑要点
- 先在香港机器上装好驱动与推理框架(如 Ollama、vLLM),用 7B 模型压测内地访问延迟。
- 将金融数据、向量库放在独立数据盘,做好磁盘加密与访问日志,便于合规留痕。
- 内地访问走 CN2 线路,必要时加一层反向代理做鉴权,避免模型接口裸奔被刷。
- 坑一:只看带宽数字不看线路,国际带宽晚高峰掉速严重。坑二:忽略防御,AI 服务暴露公网后常被扫端口。坑三:用低配 CPU 机器硬跑大模型,体验差还误判“私有化不可行”。
选购推荐
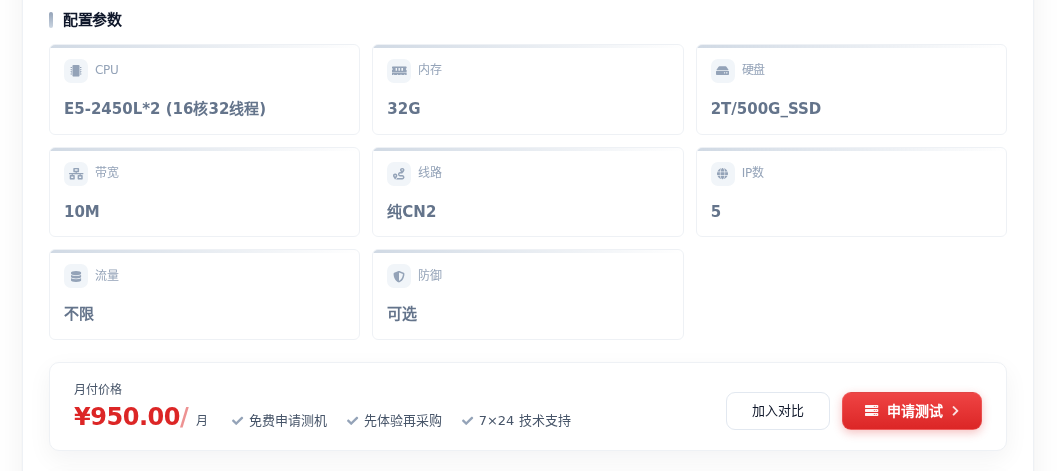
结合跨境金融数据不出境与内地低延迟的双重诉求,编辑建议优先考虑香港自营物理服务器。若以 7B~13B 模型推理、内部知识库和客服为主,香港自营物理服务器②(E5-2450L*2 / 32G / 2T+500G SSD / 10M 带宽,950 元/月)性价比合适,CN2 线路保障内地访问,免备案即买即用。
若涉及 AI 绘画、数字人素材生成或短剧译制等大带宽场景,可看香港大带宽服务器 XV(Platinum-8168*2 / 64G / 1T NVME / G 口带宽 / 500T 流量,358.5 元/月),NVMe 加快模型与素材读写,G 口应对并发上传。两款均支持真机测试,不满意 7 天全额退款,建议先测内地延迟再决定。
决策建议:验证阶段用云 GPU 试跑,生产阶段把模型和数据放到香港物理机,用 CN2 线路服务内地团队,用大带宽机型覆盖东南亚客户。先明确数据边界与并发量,再按显存和带宽反推配置,比盲目堆 GPU 更省钱。