怎样部署香港服务器跑DeepSeek?外贸企业避坑与选型指南
做TikTok Shop或独立站的外贸团队,最近常遇到同一个问题:想用DeepSeek给客服自动回复、给产品描述做多语言生成,但把模型放在美西或欧洲,内地运营同事访问后台转圈,东南亚买家点开客服要等五秒。延迟每多一秒,询盘转化率就往下掉。香港机房恰好卡在中间——到内地走CN2直连,到新加坡、越南、印尼走国际带宽,物理距离都在30ms量级以内。但真下手买机器时,坑比想象得多。
第一步:算清显存和带宽,别被“大模型”吓住
DeepSeek有多个尺寸,外贸客服场景通常用7B到32B的蒸馏版或量化版就够。显存估算有个粗略公式:FP16精度下,参数量×2GB。7B模型约需14GB显存,32B约需64GB。如果用量化版(GPTQ/AWQ 4bit),显存需求降到四分之一左右,一张24GB显存的卡能跑32B量化模型。CPU推理也能跑,但token生成速度会掉到每秒几个字,客服场景基本不可用。
带宽估算更容易被忽略。假设每天500次对话,每次平均输入200字、输出150字,按中文约1.5字/token算,一天总token量约26万。推理是计算密集型,网络传输的是文本,10M带宽足够几十个并发。真正吃带宽的是模型文件下载和后续的RAG知识库同步——一个量化后的32B模型约20GB,用10M带宽拉取要四五个小时,建议首次部署时临时升配或本地传盘。
第二步:香港服务器的选型清单与配置建议
选购时逐项核对以下参数,缺一项都可能返工:
- 线路类型:必须确认是CN2 GIA或CN2 GT,普通BGP国际线路晚高峰内地访问会绕路。香港到内地走CN2,延迟通常在10-40ms,普通线路可能到80ms以上。
- 带宽与流量:推理业务带宽需求不高,但RAG知识库更新、模型热更新会吃流量。优先选不限流量或大流量套餐,避免月底限速。
- IP类型:需要原生IP,否则部分东南亚支付网关或TikTok接口会风控。站群需求另说。
- 实名与备案:香港机房一般免实名,即买即用。内地机房跑AI推理需备案,周期长,外贸业务等不起。
- 退款政策:能真机测试、不满意全额退款的商家,试错成本最低。
配置量级参考:7B量化模型+轻量RAG,8核16G内存+一张入门级GPU或纯CPU推理可跑,但CPU方案延迟高;32B量化模型建议16核32G以上+24G显存。纯CPU跑7B量化,8核16G也能出结果,只是响应慢,适合内部测试。
第三步:部署实操与三个高频坑
部署流程不复杂:选香港服务器→装驱动和推理框架(Ollama或vLLM)→拉取模型→配API端口→对接客服系统。Ollama适合快速验证,vLLM适合生产环境高并发。RAG知识库用向量数据库存产品手册和FAQ,检索后拼进prompt。
高频坑一:只看价格不看线路。同样标“香港服务器”,CN2和普通BGP内地访问体验差三倍,买前让服务商提供测试IP,用tracert看路由是否经过CN2节点。高频坑二:低估内存。模型加载后常驻内存,加上向量库和系统开销,32G内存跑32B模型会OOM,建议内存至少是显存的1.5倍。高频坑三:忽略数据合规。东南亚部分国家要求用户数据本地化,香港作为中转节点,需在隐私政策中明确数据流向,避免客户数据直接落库到未授权区域。
选购推荐与决策建议
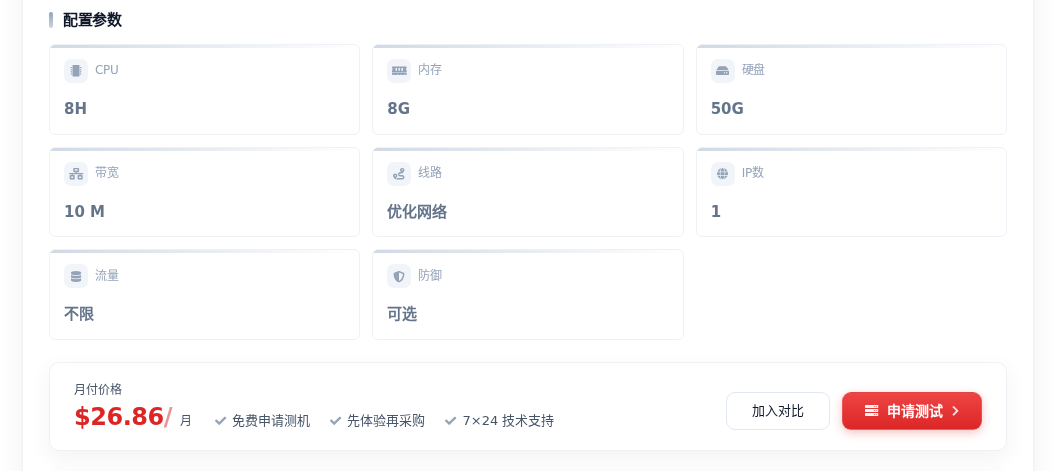
如果团队刚起步,先用低配验证业务闭环:香港云服务器 8H/8G/50G/10M,20.66元/月,跑7B量化模型做客服原型足够,CN2线路内地访问延迟低,免实名即买即用,测完不满意可退。当并发上来、需要跑32B模型或加RAG知识库时,换到香港原生IP物理服务器 ②,Xeon Gold 6138*2、256-512GB内存、800GB SSD*8,20M带宽,1352元/月,原生IP对东南亚支付和TikTok接口更友好,大内存扛得住模型常驻和向量检索。
决策逻辑很简单:先用低配云服务器跑通业务,确认延迟和效果达标后,再按并发量升级到物理机。别一上来就买顶配,也别为了省几十块选普通线路——外贸业务丢一个询盘,损失就超过一年差价。